Un workflow Make peut automatiser votre activité… ou propager une erreur à la vitesse d’un clic. Avant de connecter vos outils, vérifiez chaque déclencheur, donnée, filtre et scénario de secours. Savoir comment auditer un workflow Make avant de le mettre en production permet d’éviter les doublons, les fuites d’informations et les factures qui prennent soudainement de l’embonpoint. Ne faites pas confiance à un test réussi par hasard : utilisez cette checklist pour traquer les failles, sécuriser les échanges et déployer une automatisation fiable, même lorsque personne ne la surveille.
Définir le périmètre et les risques du scénario
Avant toute vérification technique, décrivez précisément le rôle du workflow Make. Listez son déclencheur, ses applications connectées, ses données traitées et son résultat attendu. Cette description constitue votre référence de contrôle. Elle permet aussi de distinguer les fonctions indispensables des automatisations secondaires. Sans périmètre clair, vous risquez de valider un scénario qui fonctionne, mais qui ne répond pas réellement au besoin métier.
Identifiez ensuite les conséquences d’une exécution incorrecte. Un doublon dans un CRM, une facture envoyée au mauvais client ou une donnée personnelle exposée ne présentent pas le même niveau de gravité. Classez chaque risque selon son impact et sa probabilité. Concentrez vos premiers tests sur les étapes capables de bloquer l’activité, de créer une erreur financière ou de dégrader l’expérience client.
Pour réussir à comprendre comment auditer un workflow Make avant de le mettre en production, adoptez une logique de validation progressive. Ne contrôlez pas uniquement le résultat final. Vérifiez chaque transformation, chaque filtre et chaque embranchement. Votre objectif consiste à prouver que le scénario reste prévisible lorsque les données sont incomplètes, inhabituelles ou reçues dans un ordre différent.
Cartographier les données et les dépendances
Commencez par suivre le parcours d’une donnée depuis le déclencheur jusqu’au dernier module. Notez son format initial, ses transformations et sa destination. Vérifiez notamment les champs obligatoires, les valeurs par défaut et les conversions de date, de texte ou de nombre. Une cartographie simple révèle rapidement les ruptures entre deux applications pourtant correctement connectées.
Contrôlez ensuite les dépendances externes du scénario. Une API peut imposer une authentification, une limite d’appels ou un format précis. Un module peut également dépendre d’un identifiant créé par une étape précédente. Documentez ces conditions dans votre procédure d’exploitation. Vous saurez ainsi quoi vérifier si un service évolue, si un jeton expire ou si une réponse devient incomplète.
Utilisez l’interface officielle de la plateforme d’automatisation Make pour examiner les connexions et les paramètres du scénario. Ne vous contentez pas de constater qu’une connexion est active. Vérifiez le compte utilisé, les autorisations accordées et l’environnement concerné. Une connexion personnelle ou de test peut créer un risque majeur après le déploiement.
Tester le scénario avec des données contrôlées
Créez un jeu de données de test représentatif, mais sans informations sensibles réelles. Incluez un cas nominal, un champ vide, une valeur inattendue et un enregistrement déjà traité. Chaque entrée doit répondre à une question précise. Vous vérifierez ainsi la logique fonctionnelle, plutôt que de lancer des tests improvisés difficiles à interpréter.
Exécutez les modules progressivement et examinez les bundles générés à chaque étape. Contrôlez le contenu, le type et la structure des données transmises au module suivant. Si une valeur disparaît ou change de format, corrigez le mapping immédiatement. Une validation du seul résultat final peut masquer une anomalie qui réapparaîtra avec un autre profil de données.
Répétez les essais après chaque modification importante. Comparez les résultats obtenus avec le comportement attendu et consignez les écarts. Testez également plusieurs exécutions rapprochées lorsque le scénario utilise un webhook ou un déclencheur fréquent. Cette méthode permet d’identifier les doublons, les conflits de traitement et les dépendances temporelles avant l’activation réelle.
Contrôler les erreurs, les doublons et les reprises
Un workflow fiable ne se limite pas au chemin de réussite. Simulez une erreur d’authentification, une réponse vide, une indisponibilité temporaire et une donnée invalide. Vérifiez alors le comportement de chaque route. Le scénario doit interrompre, ignorer, notifier ou reprendre l’opération selon une règle explicitement définie. Une absence de décision transforme une erreur ponctuelle en incident difficile à diagnostiquer.
Analysez aussi le risque de double traitement. Un même événement peut être reçu plusieurs fois ou relancé après une interruption. Prévoyez un identifiant unique, une recherche préalable ou une condition empêchant la création d’un doublon. Cette précaution concerne particulièrement les contacts, commandes, paiements, tickets et messages envoyés automatiquement.
Définissez enfin une procédure de reprise compréhensible. Indiquez qui reçoit l’alerte, quelles informations doivent être vérifiées et dans quel ordre relancer le scénario. Évitez les relances aveugles : elles peuvent reproduire une action déjà effectuée. Avant la mise en production, provoquez volontairement une erreur contrôlée et confirmez que le diagnostic reste exploitable.
Vérifier la sécurité et les permissions
Passez en revue les accès accordés à chaque application. Conservez uniquement les autorisations nécessaires au fonctionnement du scénario. Si un module peut lire, modifier et supprimer des données alors qu’il doit seulement les consulter, réduisez ses privilèges. Cette vérification limite l’impact d’une mauvaise configuration ou d’une compromission d’identifiants.
Inspectez les données sensibles présentes dans les champs, les journaux et les notifications. Évitez d’envoyer des informations confidentielles dans un canal d’alerte trop largement accessible. Contrôlez également les adresses utilisées par les emails et les environnements de destination. Un scénario correctement exécuté peut néanmoins provoquer une fuite si ses destinataires ou ses connexions sont mal paramétrés.
Séparez autant que possible les comptes de test et de production. Vérifiez les noms des connexions, des bases, des listes et des dossiers avant l’activation. Ajoutez une validation humaine pour les actions irréversibles ou coûteuses. Cette barrière ne ralentit pas nécessairement le processus ; elle évite surtout qu’une erreur de mapping atteigne directement un client ou un système critique.
Décider du lancement avec une checklist de production
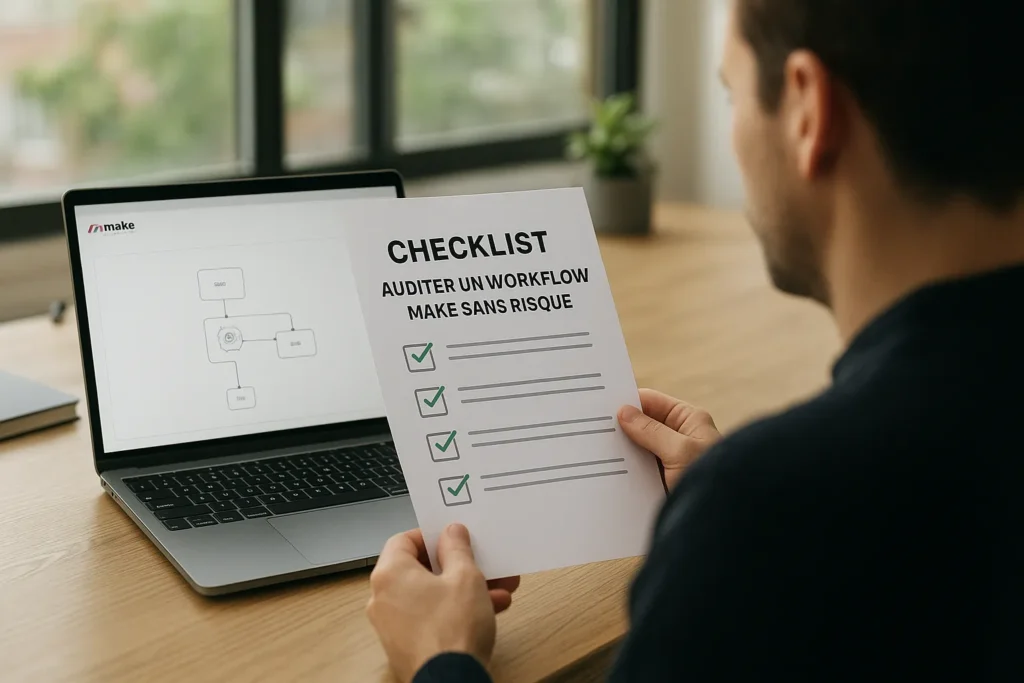
Ne publiez pas le scénario dès que le test principal réussit. Utilisez une checklist de sortie regroupant le périmètre validé, les connexions, les mappings, les filtres, les erreurs et les permissions. Chaque point doit recevoir une réponse claire : validé, corrigé ou bloquant. Cette discipline évite les décisions fondées sur une impression générale de bon fonctionnement.
Contrôlez les paramètres opérationnels avant l’activation. Vérifiez la fréquence d’exécution, les conditions du déclencheur, les notifications et la consommation attendue. Confirmez également que les personnes responsables savent consulter l’historique et reconnaître une exécution anormale. La production doit commencer avec un responsable identifié, pas avec une équipe supposant que le scénario s’auto-surveillera.
Activez enfin le workflow de manière progressive lorsque le contexte le permet. Commencez par un périmètre limité, observez les premières exécutions et comparez les résultats aux attentes. Conservez une possibilité de désactivation rapide. Un audit réussi ne promet pas l’absence totale d’incident ; il garantit surtout que les risques sont connus, surveillés et maîtrisables.
Avant de publier, vérifiez une dernière fois les données sensibles, les scénarios d’erreur, les doublons et les limites de chaque module. Savoir comment auditer un workflow Make avant de le mettre en production permet surtout de remplacer les suppositions par des contrôles concrets et traçables. Lancez ensuite le scénario avec un jeu de données réduit, activez les alertes utiles et documentez la procédure de reprise en cas d’échec. Cette rigueur vous donne une automatisation plus fiable, plus facile à maintenir et suffisamment sûre pour accompagner la croissance de votre activité.